RAG nedir? Şirket belgelerinizle konuşan yapay zekâ asistanı
Yapay zekâ modelleri şirketinizin belgelerini bilmez. RAG bu boşluğu nasıl kapatır, nasıl çalışır ve kurarken nelere dikkat etmek gerekir?
Genel amaçlı bir yapay zekâ modeli birçok konuda iyi cevap verir, ama şirketinizin iade politikasını, bayi sözleşmesini ya da ürün kataloğunu bilmez. Bunları sorduğunuzda ya "bilmiyorum" der ya da daha kötüsü, makul görünen ama yanlış bir cevap üretir. Şirket içi asistanlarda bu sorunu çözmek için en yaygın kullanılan yöntem RAG'dir.
RAG ne demek?
RAG, Retrieval-Augmented Generation ifadesinin kısaltması. Türkçesiyle "geri getirme destekli üretim" diyebiliriz. Yöntem 2020'de Patrick Lewis ve arkadaşlarının yayımladığı makaleyle yaygınlaştı[1]. Fikir basit: model cevap yazmadan önce ilgili bilgiyi bir belge koleksiyonunda arar ve cevabını bulduğu metne dayandırır.
Bunun iki önemli sonucu var. Modeli şirket verisiyle yeniden eğitmek gerekmez. Belgeleriniz güncellendiğinde asistanın bilgisi de güncellenir.
Adım adım nasıl çalışır?
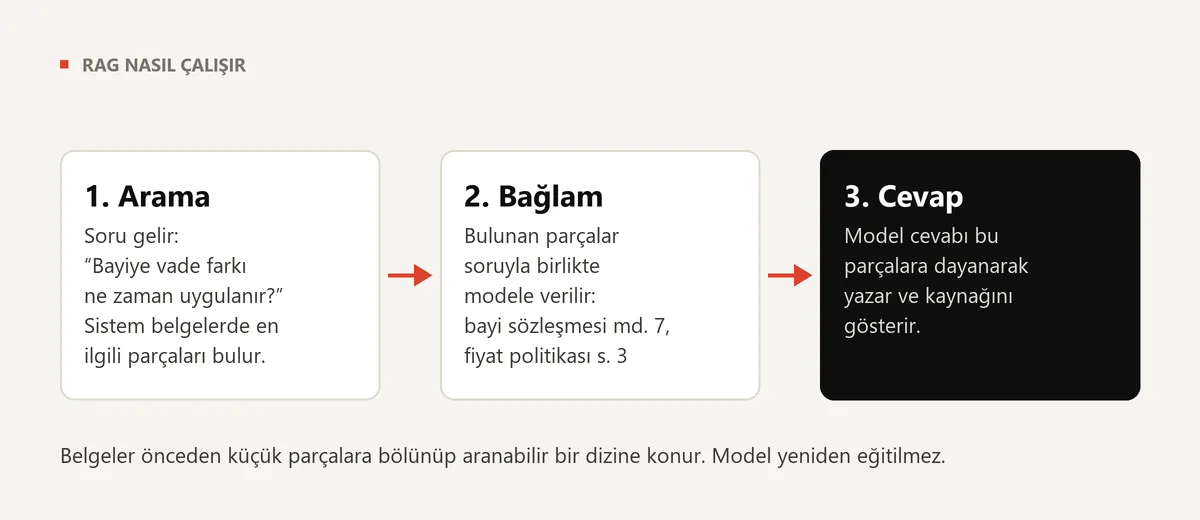
- Hazırlık: PDF, Word, wiki sayfaları ya da e-postalar küçük parçalara bölünür ve aranabilir bir dizine konur. Genellikle kelimeye değil anlama göre arama yapabilen bir "vektör dizini" kullanılır.
- Arama: Bir çalışan soru sorar: "Bayiye vade farkı hangi durumda uygulanıyor?" Sistem bu soruya en yakın parçaları bulur.
- Cevap: Bulunan parçalar soruyla birlikte modele verilir. Model cevabı bu metinlere dayanarak yazar ve hangi belgeden aldığını gösterir.
Kalitenin anahtarı arama
Cevabın doğruluğu çoğu zaman modelden çok aramanın doğru parçayı bulmasına bağlıdır. Anthropic'in Eylül 2024'te yayımladığı çalışma bunu sayılarla gösteriyor. Her parçaya belgenin bütününden kısa bir bağlam açıklaması eklemek, anlam aramasını klasik kelime aramasıyla (BM25) birleştirmek ve sonuçları yeniden sıralamak, doğru parçanın bulunamadığı durumları %67 azalttı[2].
Uygulamadaki karşılığı şu: Belgeleri rastgele bölmek yerine her parçaya belge adı, tarih, ürün kodu gibi bilgileri ekleyin. Hem anlam hem kelime araması yapın. Ürün kodları ve sözleşme numaraları kelime aramasında çok daha iyi bulunur.
Aynı çalışma bir şeyi daha hatırlatıyor: Bilgi tabanınız küçükse, yani yaklaşık 200.000 token'dan (birkaç yüz sayfalık metin) azsa, RAG'e gerek olmayabilir. Belgelerin tamamı doğrudan modele verilebilir[2].
Kurarken dikkat edilmesi gerekenler
- Yetki: Asistan, soran kişinin görmeye yetkisi olmayan bir belgeyi cevabına katmamalı. Yetki kontrolü arama aşamasında yapılmalı. OWASP'nin 2025 listesinde "vektör ve embedding zayıflıkları" ayrı bir risk başlığı[3].
- Belgeye gizlenmiş talimatlar: Dizine giren bir belgedeki gizli bir talimat modeli yönlendirebilir. Buna "prompt injection" deniyor ve aynı listenin ilk sırasında[3]. Müşteri e-postası, tedarikçi dosyası gibi dışarıdan gelen belgeler ayrı tutulmalı.
- Güncellik: Eski fiyat listesi dizinde kalırsa asistan eski fiyatı söyler. Hangi belgenin ne zaman güncelleneceği ve eski sürümün nasıl kaldırılacağı baştan belirlenmeli.
- Kaynak gösterme: Her cevabın altında belge adının görünmesi, kullanıcının cevabı kontrol etmesini sağlar ve asistana güveni artırır.
Şirketiniz için ne anlama geliyor?
- Ekibinizin sık sorduğu soruların cevabı iç prosedürlerde, ürün kataloğunda, teknik dokümanlarda ya da sözleşmelerde duruyorsa RAG iyi bir başlangıç noktası.
- Küçük başlayın: Tek bir belge grubu ve tek bir ekip. Örneğin satış ekibi için ürün kataloğu.
- Başarıyı ölçün: 30–50 gerçek soru hazırlayın ve asistanın cevaplarını doğru ya da yanlış diye işaretleyin.
- Verinin nerede duracağına baştan karar verin: bulut mu, şirket içi sunucu mu? Kişisel veri içeren belgeleri KVKK açısından ayrıca değerlendirin.
- Stok, bakiye gibi ERP'deki anlık veriler için RAG yerine doğrudan sorgu daha doğru sonuç verir. İkisi aynı asistanda birlikte kullanılabilir.
İzlemek isterseniz
- What is Retrieval-Augmented Generation (RAG)?IBM Technology · yaklaşık 7 dk · İngilizce
Şirket belgelerinizle çalışan bir asistan kurmak isterseniz kurumsal yapay zekâ hizmetimize göz atın.
Kaynaklar
- Lewis, P. ve diğerleri, "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", arXiv, 22 Mayıs 2020. arxiv.org/abs/2005.11401
- Anthropic, "Introducing Contextual Retrieval", 19 Eylül 2024. anthropic.com/news/contextual-retrieval
- OWASP, "Top 10 for LLM Applications 2025" (LLM01 Prompt Injection, LLM08 Vector and Embedding Weaknesses). genai.owasp.org/llm-top-10